
Jos tekoälyoptimoinnin käsitteet, kuten GEO ja AEO, ovat vielä uusia, aloita oppaastamme generatiivisesta hakukoneoptimoinnista. Tämä kirjoitus syventää sen rinnalla yhtä näkökulmaa: konetta asiakkaana.
Kirjoitus pohjautuu Hionin webinaariin Asiakkaana kone ja ihminen: miten palvelet verkossa molempia? Käy katsomassa tallenne täältä.
Lyhyesti
- Konekokemus (MX) on se osa asiakaspolkua, jonka tekoäly käy läpi ennen kuin ihminen saapuu sivustolle – tai jättää saapumatta.
- Kolmenlaiset koneet käyttävät sivustoasi: koulutusbotit, haku- ja fetch-botit sekä selainagentit. Vain kaksi jälkimmäistä voi tuoda kävijöitä.
- Ihminen lukee tunteella, kone raakaa HTML:ää. Se, mikä parantaa ihmisen kokemusta, voi tehdä sisällöstä koneelle näkymätöntä.
- Tekoäly pilkkoo kysymyksen alahauiksi. Mitä useampaan alahakuun sivusi vastaa, sitä todennäköisemmin siitä tulee lähde.
- Voit hallita sisältöä ja koodia, et tekoälyn valintoja. Siksi omaa asemaa kannattaa testata kuukausittain samoilla kysymyksillä.
Mitä konekokemus tarkoittaa?
Konekokemus (machine experience, MX) on se, miten tekoälypalvelut ja botit löytävät, lukevat ja ymmärtävät verkkosivustosi. Se ratkaisee, pääseekö yrityksesi ylipäätään vaihtoehdoksi, jonka ihminen näkee.
Zero-click-ilmiöllä tarkoitetaan sitä, että käyttäjä saa vastauksen suoraan tekoälyltä tai hakukoneelta eikä klikkaa enää sivustolle. Webinaarissa ostopolku jaettiin kahteen osaan:
- Ostaja kysyy tekoälyltä. (konekokemus)
- Tekoäly karsii vaihtoehdot. Jo yli puolet Google-hauista päättyy ilman klikkausta, ja tekoälyn suorat vastaukset voimistavat kehitystä. (konekokemus)
- Ihminen saapuu sivustolle. (asiakaskokemus, CX)
- Kontakti tai osto. (asiakaskokemus)
Ihmisen asiakaskokemus alkaa vasta, kun hän saapuu sivustolle. Sitä ennen tekoäly on jo tehnyt esikarsinnan sen perusteella, mitä se sivustostasi ja yrityksestäsi ymmärsi. Puhujien mukaan tekoälyn kanssa käydyistä keskusteluista vain murto-osa johtaa klikkaukseen.
Haku itsessään ei ole kadonnut – ihmiset kysyvät edelleen. Klikkauksen rooli on kuitenkin muuttunut, ja sen mukana muuttuu myös se, mitä esimerkiksi hakusanamainonnassa on totuttu mittaamaan ja maksamaan.
Millaiset koneet sivustollasi vierailevat?
Konekokemus palvelee kolmenlaisia koneita: koulutusbotteja, haku- ja fetch-botteja sekä selainagentteja. Vain kaksi jälkimmäistä voi tuoda sivustollesi kävijöitä. Webinaarissa todettiin myös, että jo yli 60 % verkkoliikenteestä on bottiliikennettä.
| Kone | Mitä se tekee | Mitä siitä seuraa |
|---|---|---|
| Koulutusbotit | Keräävät sisältöä kielimallien opettamiseen. | Eivät tuo kävijöitä. |
| Haku- ja fetch-botit | Hakevat sivun reaaliajassa vastausta varten. | Voivat tuoda viittausliikennettä. |
| Selainagentit, kuten ChatGPT Agent ja Claude selaimessa | Klikkaavat, vertailevat ja täyttävät lomakkeita käyttäjän puolesta. | Käyttävät sivua kuin ihminen. |
Neljä reittiä tekoälyn vastaukseen
Kun joku kysyy esimerkiksi ChatGPT:ltä, Claudelta tai Geminiltä, mistä saa syksyn parhaan sateenvarjon, vastaus voi syntyä neljää eri reittiä:
- Mallin muisti eli koulutusdata. Malli tuntee yrityksesi valmiiksi, koska se on lukenut sivustosi aiemmin. Tieto voi kuitenkin olla jopa vuoden vanhaa, eikä siihen voi vaikuttaa muuten kuin sivuston sisällöllä.
- Hakuindeksi. Tekoäly etsii tietoa esimerkiksi Googlen tai Bingin kautta.
- Reaaliaikainen haku. Tekoälypalvelu noutaa sivusi sisällön juuri sillä hetkellä.
- Agentti. Agentti avaa sivun itse, vertaa tuotteita kilpailijoihin ja voi jopa tehdä ostoksen käyttäjän puolesta.
Jokaiseen reittiin vaikuttavat hieman eri tekniset ja sisällölliset tekijät. Siksi konekokemusta kannattaa tarkastella kokonaisuutena eikä yksittäisenä temppuna.
Miten ihminen ja kone lukevat sivua eri tavalla?
Ihminen lukee tunteella ja silmäillen, kone lukee raakaa HTML:ää alusta loppuun. Se, mikä parantaa ihmisen kokemusta, voi tehdä sisällöstä koneelle näkymätöntä.
| Ulottuvuus | Ihminen | Kone |
|---|---|---|
| Luottamus | Brändi, design ja suositukset | Johdonmukaiset faktat ja rakenteinen data |
| Brändi ja sävy | Erottaa kilpailijoista | Tiivistyy pois, vain sisältö jää |
| Lukeminen | Silmäilee kokonaisuutta | Lukee raakaa HTML:ää alusta loppuun |
| JavaScript | Rikastaa kokemusta | Useimmille boteille näkymätöntä |
| Kuvat ja video | Vahvistavat tunnelmaa | Näkymättömiä ilman alt-tekstiä |
| Navigointi | Valikot ja visuaalinen hierarkia | Otsikkohierarkia, linkit ja sivukartta |
| Sisällön rakenne | Tarina ja koukku houkuttelevat lukemaan | Suora vastaus heti alussa, faktat ja luvut |
Koneet luottavat erityisesti siihen, että sama tieto toistuu yhtenevänä useissa eri lähteissä. Navigaatiovalikot ovat käytännössä vain ihmisiä varten, joten jokaisen sivun on oltava saavutettavissa myös sivukartan ja linkkien kautta.
Dynaamisesti ladattu sisältö on erityinen riski: ihmiselle sujuva ratkaisu voi jättää botin tyhjän sivun ääreen. Samoin kuvissa ja videoissa kerrottu tieto katoaa, jos sitä ei ole myös tekstinä.
Ihminen reagoi sanoihin, kone signaaleihin
Sanavalinnat vaikuttavat ihmisen luottamukseen. Webinaarissa esitetyn esimerkin mukaan ihmiset suhtautuvat myönteisemmin tuotteeseen, jota kutsutaan älykkääksi (”smart”), kuin samaan tuotteeseen nimellä ”AI-powered”. Koneelle nimellä ei ole merkitystä – se reagoi sisällön signaaleihin.
Tutkimuksissa näkyvyys tekoälyvastauksissa on parantunut noin 30–40 %, kun sisältöön on lisätty relevantteja tilastoja ja lähdeviittauksia. Pelkkä avainsanojen viilaus ei enää riitä.
Miten tekoäly valitsee lähteensä?
Tekoäly valitsee lähteensä alahakujen perusteella. Sivu, joka vastaa useaan alahakuun, päätyy todennäköisemmin vastaukseen kuin sivu, joka on optimoitu yhdelle hakusanalle. Tämä on käytännön syy siihen, miksi GEO:ssa optimoidaan aihekokonaisuuksia eikä yksittäisiä termejä. GEO:n ja SEO:n suhdetta käsitellään tarkemmin oppaassamme.
Tekoäly ei tee kysymyksestä vain yhtä hakua. Se pilkkoo kysymyksen useammaksi alahauksi ja kokoaa vastauksen niistä sisällöistä, jotka vastaavat alahakuihin parhaiten.
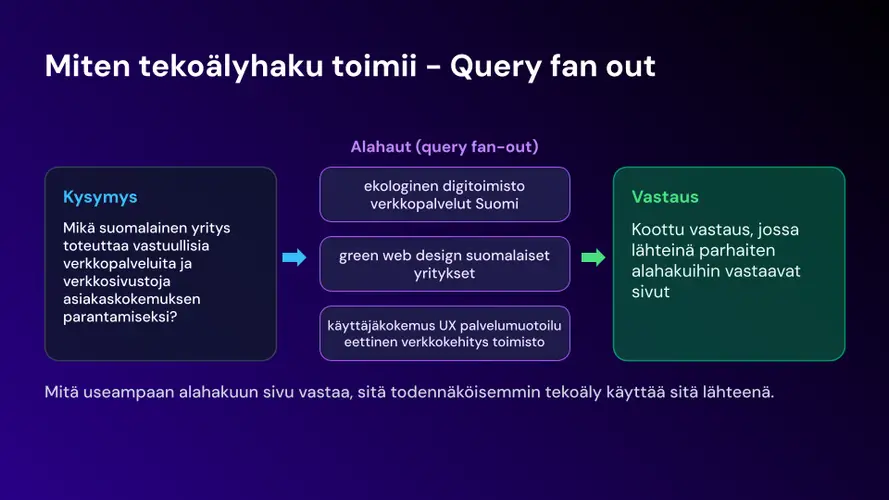
Tästä syystä sisällön kannattaa kattaa koko aihealue eikä vain yksittäistä hakusanaa. Mitä useampaan alahakuun sivustosi vastaa, sitä todennäköisemmin se päätyy tekoälyn lähteeksi.
Mitä konekokemuksessa voi hallita ja mitä ei?
Sisältöä ja koodia voi hallita, tekoälyn valintoja ei. Hyvällä konekokemuksella parannat todennäköisyyttä sille, että juuri sinun brändisi, tuotteesi ja palvelusi nousevat tekoälyn vastauksiin.
| Voit hallita | Et voi hallita |
|---|---|
| Sisällön laatu ja rakenne – tärkein yksittäinen tekijä | Lähdevalinnat – mitkä lähteet tekoäly nostaa vastaukseen |
| Tekninen löydettävyys – Schema.org, sivukartta, robots.txt | Sisäiset vastaukset – vastaukset, jotka malli antaa koulutusdatansa pohjalta ilman verkkohakua |
| Ajantasaiset tiedot – esimerkiksi hinnat ja saatavuus | Muutosten nopeus – tekoälyindeksointi on hitaampaa kuin perinteinen |
| Kattava UKK-sisältö – suorat vastaukset asiakkaiden todellisiin kysymyksiin | Vastausten vaihtelu – sama kysymys voi tuottaa eri kerroilla eri vastauksen |
Tekninen perusta: ensin botin on päästävä sisään
Konekokemus alkaa siitä, että botti pääsee sivustolle ja löytää sisällön. Webinaarissa nimettiin yleisimmäksi esteeksi robots.txt, joka toimii sivuston portinvartijana. Sen jälkeen sivukartta ohjaa botit tärkeille sivuille, Schema.org-merkinnät kertovat, mitä sivulla on, ja tärkeä sisältö tarjotaan HTML:nä eikä JavaScriptin varassa.
Tekninen tekoälyoptimointi on käyty läpi kohta kohdalta oppaassamme.
Miten sama sisältö palvelee sekä ihmistä että konetta?
Tekoäly käyttää todennäköisimmin sisältöä, joka vastaa täsmällisesti esitettyyn kysymykseen. Avauskappaleen pitää kertoa olennainen heti, ja tietojen on oltava ajan tasalla.
Sisältöä tehdään silti lopulta ihmisille. Kyse ei ole ihmisen ja koneen vastakkainasettelusta, vaan siitä, että sisällössä tulee vastata konkreettisiin kysymyksiin selkeästi ja yhdenmukaisesti.
Käytännössä tämä tarkoittaa, että vastaus ja faktat tulevat ensin, tarina ja brändin ääni niiden ympärille. Paras lähde sisällön aiheille ovat myyjät ja asiakaspalvelu, koska he tietävät, mitä asiakkaat oikeasti kysyvät. Vastauslähtöisen sisällön rakenne ja E-E-A-T-signaalit on käyty läpi oppaassamme.
Tilastot painavat – myös virheelliset
Tilastot ja lähdeviittaukset ovat konekokemuksen kannalta ratkaisevia. Webinaarissa kerrottiin esimerkki palvelusta, jonne tuotettiin tuhansittain uskottavan näköisiä mutta keksittyjä tilastoja, muun muassa tekoälyn käytöstä Suomessa. Taulukoiden ja lukujen takia tekoäly antoi sisällölle paljon painoarvoa, ja virheellisiä lukuja päätyi siteerattavaksi jopa tieteellisiin artikkeleihin.
Opetus on kaksijakoinen: tarkistettu data on vahva signaali tekoälylle, mutta juuri siksi sen on oltava oikeaa. Omat luvut kannattaa aina perustella ja lähteistää.
Kone kokee brändisi myös muualla kuin sivustollasi
Tekoäly kokoaa kuvan brändistäsi koko verkosta, ei pelkästään yrityksesi omilta sivuilta. Siksi tietojen on oltava samat kaikissa kanavissa.
Tekoäly hyödyntää esimerkiksi brändimainintoja mediassa ja vertailusivuilla, asiakasarvioita, Wikipediaa, YouTubea ja LinkedIniä. Konekokemuksen näkökulmasta tärkeintä on johdonmukaisuus: kone luottaa tietoon, joka toistuu samana useassa lähteessä, joten ristiriitaiset hinnat, palvelukuvaukset tai yhteystiedot heikentävät asemaasi. PR:llä on edelleen iso rooli, ja keinot ulkoisten luottamussignaalien vahvistamiseen löytyvät oppaastamme.
Miten testaat tekoälynäkyvyyttäsi itse?
Tekoälynäkyvyyttä ei voi mitata yhtä tarkasti kuin perinteistä hakua. Helpoin tapa on kysyä tekoälyltä aitoja asiakaskysymyksiä joka kuukausi ja kirjata tulokset.
- Kysy. Esitä kysymyksiä tuotteistasi, palveluistasi ja toimialastasi esimerkiksi ChatGPT:lle, Geminille, Perplexitylle ja Claudelle.
- Vertaa. Miten vastaukset eroavat eri tekoälytyökalujen välillä?
- Luokittele. Olitko ykkösvaihtoehto, hyvä vaihtoehto, yksi monista vai pelkkä maininta? Kirjaa myös, mitä muita lähteitä vastauksissa käytettiin.
- Tarkista data. Seuraa AI Overview -näkyvyyttä Search Consolesta ja tekoälylähteistä tulevaa liikennettä GA4:stä.
- Tarkista faktat. Varmista, että tekoälyn vastauksissa esitetyt brändi- ja tuotetiedot pitävät paikkansa.
Käytä joka kuukausi samoja kysymyksiä ja dokumentoi tulokset, niin näet muutoksen suunnan. Sama kysymys voi tuottaa eri kerroilla eri vastauksen, joten kysy sama asia useamman kerran ja eri aikoina – tarvittaessa jopa monta kertaa saman päivän aikana.
Testaamisen voi aloittaa jo ennen muita toimenpiteitä. Silloin näet, onko tekemilläsi muutoksilla vaikutusta.
Tee testit väliaikaisessa keskustelussa tai erillisellä tilillä. Muuten oma muistisi ja keskusteluhistoriasi voivat vääristää tuloksia, koska tekoäly tietää esimerkiksi, missä olet töissä.
Kun haluat seurata näkyvyyttä järjestelmällisemmin, oppaassamme esitellään tekoälyhaun mittarit ja seurantatyökalut.
Mistä aloittaa? Neljä askelta
- Tarkista robots.txt, Schema.org-merkinnät ja sivukartta. Robots.txt:n pitää sallia hakubotit, ja merkintöjen pitää kertoa tekoälylle, mikä sivulla on mitäkin.
- Kerää myyjiltä ja asiakaspalvelulta asiakkaiden todelliset kysymykset, joihin he kaipaavat vastauksia.
- Kirjoita vastaukset näihin kysymyksiin ja muotoile sisältö tekoälyn suosimalla tavalla: tiivistelmät, listat, UKK-osiot ja taulukot.
- Aloita kuukausittainen testaus, jotta saat kuvan tekoälynäkyvyydestäsi ja sen kehityksestä.
Haluatko tietää, missä sivustosi on nyt? Hionin GEO-analyysi näyttää sivustosi nykytilan ja kehityskohteet, ja tulokset käydään läpi asiantuntijan kanssa. Ota meihin yhteyttä!
Laita meille viestiä, niin katsotaan GEO-asiat kuntoon!
"*" näyttää pakolliset kentät
Usein kysytyt kysymykset
Konekokemus (MX) on se, miten botit ja tekoälyagentit löytävät, lukevat ja ymmärtävät verkkosivustosi. Se vaikuttaa siihen, päätyykö yrityksesi tekoälyn suosittelemien vaihtoehtojen joukkoon ennen kuin ihminen edes saapuu sivustolle ja sitä, kuinka tehokkaasti agentit pystyvät asioimaan sivuston kanssa.
Selainagentti on tekoäly, joka käyttää verkkosivua kuin ihminen: se klikkaa, vertailee ja täyttää lomakkeita käyttäjän puolesta. Esimerkkejä ovat ChatGPT Agent ja Claude selaimessa.
Query fan-out tarkoittaa, että tekoäly pilkkoo käyttäjän kysymyksen useaksi alahauksi ja kokoaa vastauksen sivuista, jotka vastaavat alahakuihin parhaiten.
Useimmat eivät. Tärkeä sisältö kannattaa tarjota suoraan HTML:nä.
Kysy tekoälypalveluilta aitoja asiakaskysymyksiä säännöllisesti, kirjaa asemasi vastauksissa ja seuraa AI Overview -näkyvyyttä Search Consolesta sekä tekoälylähteiden liikennettä GA4:stä. Tähän on olemassa myös erikoistuneita työkaluja, joita itse käytämme asiakkaillemme.
Tekoälyindeksointi on hitaampaa kuin perinteinen indeksointi, eikä koulutusdataan perustuviin vastauksiin voi vaikuttaa nopeasti. Siksi näkyvyyttä kannattaa seurata kuukausittain.
Ei rankaise, kunhan sama tiivistelmä näkyy myös ihmiskävijöille. Saman sivun sisällä toistuvasta tekstistä ei seuraa rangaistusta. Googlella ei myöskään ole yleistä päällekkäisen sisällön rangaistusta, ellei sisältöä monisteta harhaanjohtamistarkoituksessa.
Riski syntyy, jos tiivistelmä näytetään vain boteille tai se kertoo eri asiaa kuin sivun varsinainen sisältö. Google pitää tällaista peittelynä (cloaking). Kestävin ratkaisu on renderöidä tärkeä sisältö palvelimella, jolloin se on HTML:ssä sekä ihmisille että boteille.
Voit, mutta et tavallisessa keskustelussa, jos muisti on päällä. ChatGPT voi hyödyntää tallennettuja muistoja ja aiempia keskusteluja. Silloin se tuntee asiakkaan valmiiksi ja nostaa sen vastaukseen herkemmin kuin tavalliselle käyttäjälle.
Tee testit väliaikaisessa keskustelussa (Temporary Chat), joka ei käytä eikä tallenna muistia, tai erillisellä testitilillä. Vääristymä koskee vain omaa tiliäsi: omat keskustelusi eivät käytännössä vaikuta siihen, mitä tekoäly vastaa muille käyttäjille.
Tekoäly voi tosiaan mainita yrityksesi vastauksessa siksi, että se tietää työpaikkasi. Tämän voi estää kolmella tavalla: 1. käytä väliaikaista tai incognito-keskustelua 2. kytke muisti ja keskusteluhistorian hyödyntäminen pois asetuksista 3. testaa erillisellä tilillä, jolla ei ole työhistoriaa.
ChatGPT:ssä asetukset löytyvät personointi- tai muistiasetuksista, ja niiden nimet vaihtelevat tilaustason mukaan. Vastaavat asetukset löytyvät myös muun muassa Claudesta ja Geministä. Tarkista lisäksi mukautetut ohjeet ja projektit, sillä nekin voivat ohjata vastauksia.
Lähteet
- Aggarwal ym. (2024): GEO: Generative Engine Optimization, KDD 2024. Lähdeviittausten, sitaattien ja tilastojen lisääminen paransi näkyvyyttä tekoälyvastauksissa jopa noin 40 %.
- Hion: Generatiivinen hakukoneoptimointi (GEO), SEO ja vastausmoottorioptimointi (AEO). Zero-click-luvut ja tekoälyoptimoinnin käytännöt.